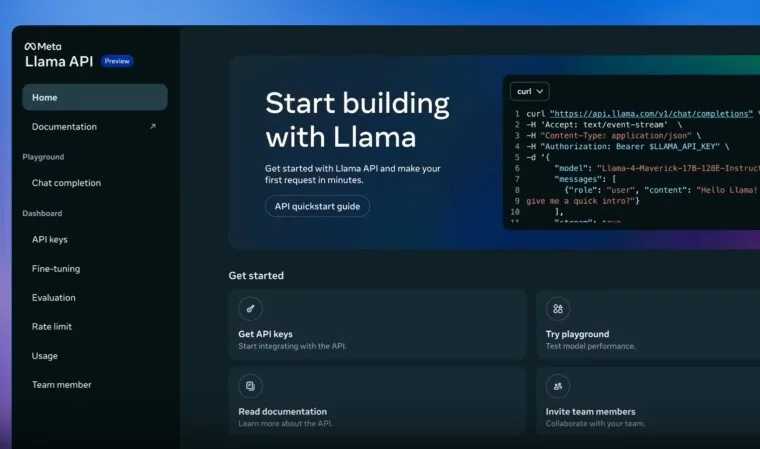
In occasione del primo LlamaCon, Meta ha fatto diversi annunci e introdotto strumenti per rendere la famiglia di modelli Llama più accessibile agli sviluppatori. Il momento clou è stato il lancio dell’API Llama, ora disponibile in anteprima gratuita e limitata per gli sviluppatori.
L’API Llama consentirà agli sviluppatori di provare diversi modelli Llama, inclusi i modelli Llama 4 Scout e Llama 4 Maverick, recentemente lanciati. Offre la creazione di chiavi API con un solo clic e SDK leggeri per TypeScript e Python. Per facilitare il porting di applicazioni basate su OpenAI, l’API Llama è compatibile con l’SDK OpenAI.
Meta collabora inoltre con Cerebras e Groq per offrire velocità di inferenza più elevate per l’API Llama. Cerebras afferma che il modello Llama 4 Cerebras nell’API può offrire velocità di generazione di token fino a 18 volte superiori rispetto alle tradizionali soluzioni basate su GPU di NVIDIA e altri. Secondo il sito di benchmarking Artificial Analysis, la soluzione Cerebras ha generato oltre 2.600 token al secondo per Llama 4 Scout, rispetto ai 130 token al secondo di ChatGPT e ai 25 token al secondo di DeepSeek.
Andrew Feldman, CEO e co-fondatore di Cerebras, ha affermato:
Cerebras è orgogliosa di aver reso l’API Llama l’API di inferenza più veloce al mondo. Gli sviluppatori che creano app agentiche e in tempo reale hanno bisogno di velocità. Con Cerebras sull’API Llama, possono creare sistemi di intelligenza artificiale che sono fondamentalmente fuori dalla portata dei principali cloud di inferenza basati su GPU.
Gli sviluppatori interessati possono accedere a questa inferenza ultraveloce di Llama 4 selezionando Cerebras tra le opzioni del modello all’interno dell’API di Llama. Llama 4 Scout è disponibile anche su Groq , ma attualmente funziona a oltre 460 token/s, circa 6 volte più lento della soluzione Cerebras, ma 4 volte più veloce rispetto ad altre soluzioni basate su GPU.